```clojure
(reduce f [1 2 3 4 5])
;; 等价于
(f (f (f (f 1 2) 3) 4) 5)
```
```clojure
(list 1 2 3 4 5)
;; 等价于
(cons 1 (cons 2 (cons 3 (cons 4 (cons 5 nil)))))
```
Clojure 的 `reduce` 默认是左折叠,即 `foldl`:
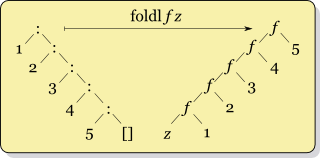
要在 Clojure 里实现右折叠,只能把待操作的列表倒序:
```clojure
(reduce f (reverse [1 2 3 4 5]))
;; 等价于
(f (f (f (f 5 4) 3) 2) 1) ; 实际上还是左折叠
;; 如果 f 和 + 一样满足交换律,就等价于
(f 1 (f 2 (f 3 (f 4 5))))) ; 等价于右折叠
```
折叠中的 `f` 本身也可以是折叠。还记得 `into` 吗?
```clojure
(into [1 2 3] [4 5])
;; => [1 2 3 4 5]
;; 等价于
(reduce conj [1 2 3] [4 5]) ;; 这里的 reduce 以 [1 2 3] 为初始值
;; 如果没有初始值,就会用第一个元素做初始值
;; 等价于
(conj (conj (conj [1 2 3]) 4) 5)
```
如果要打平一个向量,比如把 `[[1] [2 3] [4 5]]` 变成 `[1 2 3 4 5]`,就可以用 `into` 作为归约函数(reducing function),也就是把 `(reduce conj ...)` 作为 `reduce` 的 `f`。
```clojure
(reduce into [[1] [2 3] [4 5]])
;; => [1 2 3 4 5]
;; 等价于
(reduce #(reduce conj %1 %2) [[1] [2 3] [4 5]])
;; 等价于
(reduce conj (reduce conj [1] [2 3]) [4 5])
;; 等价于
(conj (conj (conj (conj [1] 2) 3) 4) 5)
```
在 Clojure 中,能够被放在 `reduce` 里使用的函数就叫作归约函数(reducing function)。这个概念与函数式编程和 Lambda 演算的高阶函数(Higher-order function)有关,据说微积分中的导数也算一种高阶函数,但我这篇文章不是讲数学的(我也不会数学),所以就点到为止。
## 改造归约函数
总结一下,归约函数就是这样的一类函数:
```
(f result input) -> new result
```
这样的函数可以相互嵌套使用,不过一般传给 `reduce` 用。
接下来要引入一种新的函数,我没有找到中文译名,暂且称作变约函数(transducer)。它长这样:
```
(t (f result input)) -> (new-f result input)
```
Transducer 接收一个归约函数,返回新的归约函数。
返回函数的函数可能有些抽象,但是在 Clojure 中很常见。我举几个例子解释 Transducer 的用法。
假设我们要对向量自增,然后再累加,就要这样写:
```clojure
;; 下面这个函数先是自增 [1 2 3 4] 得到 [2 3 4 5]
;; 然后再对 [2 3 4 5] 进行累加
(reduce + 0 (map inc [1 2 3 4]))
;; => 14
```
能不能让 `+` 这个归约函数,在把之前的结果和下一个元素累加起来之前,先给要累加的元素 `+ 1`?也就是说,我们不用遍历一遍列表,生成新的、自增后的列表,然后再累加这个列表,而是在累加的过程中就把自增的操作也做了。
我们可以这样写:
```clojure
;; 下面这个函数用 (map inc) 这个 Transducer
;; 把 + 这个归约函数,转换成了新的归约函数
;; 这个新的归约函数的作用是:先给单个元素 +1,然后再累加
(reduce ((map inc) +) 0 [1 2 3 4])
;; => 14
```
这里我们看到了 [Clojure 1.7](https://clojure.org/news/2015/06/30/clojure-17) 引入的 `map` 的新用法。一般而言,`(map f coll)` 的作用是把 `f` 作用在 `coll` 中的每一个元素上,然后生成新的元素。
而 `(map inc)` 则是生成了一个 Transducer,我们把 `+` 作为这个 Transducer 的参数传入,得到了新的归约函数。也就是说,我们将 `(map inc)` 和 `+` 组合,**构造**了新的**数据转换算法**。
对集合中的元素 `inc`,然后再折叠 `+` 实现累加。
这种转换与具体类型无关,与惰性无关,与执行顺序也无关,只是**纯粹的算法**。非常便于复用。
## 将具体类型与转换算法解耦
Clojure 的哲学是简洁,这点并不只是体现在语法(syntax)上,还体现在语义(semantics)和语言的设计上。Rich Hickey 在《[Simple Made Easy](https://www.infoq.com/presentations/Simple-Made-Easy/)》里讲到,简单(simple)的东西就是不和其他东西交织(complect)在一起的东西。
Java 类不简单,因为它既是命名空间,又是数据结构,还定义了数据上的操作——类把三个东西交织在了一起。反观 Clojure,命名空间是单独的概念。
标照 Rich 本人对简单的定义,标准库里的 `map`、`filter`、`reduce` 等操作序列的函数,都不够简单,因为他们不仅涉及做什么操作(what to do),还涉及了怎么做(how to do it)——预设了惰性,预设了数据操作的顺序(序列都是从前往后线性遍历的),预设了数据的表示方式(返回的是序列)。
如果 `map`、`filter`、`mapcat` 等函数,能够与数据类型(序列)**解耦**呢?也就是说,如果 `map` 只定义做什么操作(what to do) ,把怎么做(how to do it)交给其他组件呢?
比方说,`map` 可以这样实现:
```clojure
(defn map [f]
(fn [f1]
(fn [result input]
(f1 result (f input)))))
```
这个 `map` 是构造 Transducer 的函数,它接收函数 `f`,返回了一个返回函数的函数。我们之前看到的 `(map inc)` 就返回了一个 Transducer。
这就是对做什么(what to do)的定义。
`reduce` 则定义了怎么做(how to do it),因为 `reduce` 是对序列的操作,而且是具有惰性的,返回值是惰性序列。所以把 `reduce` 的怎么做(惰性地、顺序地、当作序列执行左折叠)与 `((map inc) +)` 的做什么(“元素自增后再累加”)组合,就得到了完整的数据操作。
如果不想要折叠呢?我能不能直接用 `(map inc)` 累加元素?
将 `sequence`(输入和输出数据为序列、惰性、顺序操作)与 `(map inc)`(“自增集合里所有的元素”)这些要素组合起来,才能得到完整的数据操作:“自增**序列**里所有的元素**逐一**自增,返回**惰性**序列。”
```clojure
(sequence (map inc) [1 2 3])
;; => (2 3 4)
```
如果不想用序列和惰性序列,可以换成向量或者集合:
```clojure
(into [] (map inc) [1 2 3])
;; => [2 3 4]
(into #{} (map inc) [1 2 3])
;; => #{4 3 2}
```
如果没有用 Transducer,我们就必须先把向量变成序列,然后再把序列变回向量。因为 `map` 和许多函数都只操作序列和惰性序列,和具体的数据类型耦合。
```clojure
(map inc [1 2 3])
;; => (2 3 4) ; <- 这里得到的是序列,而非向量
(vec (map inc [1 2 3])) ; <- 必须手动转换成向量!
;; => [2 3 4]
(into [] (map inc) [1 2 3]) ; <- Transducer 不关心数据类型
;; => [2 3 4]
```
上一篇《[异步编程和并发控制](/article/clj7/)》提到的 *channel* 也可以接收 Transducer,携带 Transuder 的 *channel* 会对经过它的所有数据做变换。
```clojure
(def growing-channel (chan 1 (map inc)))
;; => #'user/growing-channel
(put! growing-channel 1)
;; => true
(poll! growing-channel)
;; => 2
```
Transducer 的好处就是,由于他只定义了抽象的「做什么」,而不关系具体的「怎么做」,所以可以非常轻易地用在任何地方,不像 `map` 和 `filter` 只能作用于序列(或者要把向量、集等其他数据类型转换为序列)。
## 组合 Transducer
一般来说,要做 Clojure 里做一系列数据操作,会组合使用很多序列函数。
```clojure
(->> [1 2 3 4 5 6 7 8]
(filter odd?) ; 1. 过滤,只留奇数
(map #(* 2 %)) ; 2. 全部乘 2
(reduce +)) ; 3. 累加
;; => 32
```
有了 Transducer,我们可以把这一系列操作抽象出来,定义成一个独立的、可复用的操作。
```clojure
(def double-odd-numbers
(comp
(filter odd?)
(map #(* 2 %))))
; 可以用来累加
(reduce (double-odd-numbers +) 0 [1 2 3 4 5 6 7 8])
;; => 32
; 等价于
(transduce double-odd-numbers + [1 2 3 4 5 6 7 8])
;; => 32
; 可以不加,返回集合
(into #{} double-odd-numbers [1 2 3 4 5 6 7 8])
;; => #{6 2 14 10}
; 如果你想,还能交给 channel
(def double-odd-chan (chan 1 double-odd-numbers))
```
`comp` 的作用是把函数组合起来。`(comp f g)` 就相当于 `(f (g ...))`。除了用来组合 Transducer,还可以组合普通的函数:
```clojure
(filter #(not (zero? %)) [1 2 0 3 0 2 0])
;; => (1 2 3 2)
; 等价于
(filter (comp not zero?) [1 2 0 3 0 2 0])
;; => (1 2 3 2)
```
不妨做个小练习,定义一个 `pipe` 函数,作用是接收可变数量的函数[^3],将它们构造成类似 `->` 箭头宏的流水线结构,但是不执行这个结构,而是返回函数。比如 `(pipe f1 f2 f3)` 就返回按顺序执行 `f1`、`f2`、`f3` 的函数,`(pipe f1 f2 f3)` 相当于 `(f3 (f2 (f1 data)))`。