
diff options
| author | eltrac <hi@eltr.ac> | 2026-10-05 15:48:20 +0800 |
|---|---|---|
| committer | eltrac <hi@eltr.ac> | 2026-10-05 15:48:20 +0800 |
| commit | f725ec698f076cd01282352f871cf5ff28881a52 (patch) | |
| tree | 106cda201b420cbaed4d09438f5fc1b05e9a87c2 | |
| parent | 5db71115546937741273efdaf11b78064d9ecd77 (diff) | |
[edit] fix typo
| -rw-r--r-- | content/article/clj4.md | 20 | ||||
| -rw-r--r-- | content/article/clj5.md | 8 | ||||
| -rw-r--r-- | content/article/give-no-shit-about-llm.md | 10 |
3 files changed, 24 insertions, 14 deletions
diff --git a/content/article/clj4.md b/content/article/clj4.md index 501f2f77..bfba6581 100644 --- a/content/article/clj4.md +++ b/content/article/clj4.md @@ -1,6 +1,6 @@ +++ title = 'Coffee Break Clojure, Vol.4' -subtitle = 'Functioanlly Lazy' +subtitle = 'Functionally Lazy' slug = 'clj4' tags = ["Lisp","编程"] categories = '茶歇蔻芥' @@ -13,17 +13,17 @@ endnotes = [ fedi = 'https://akk.eltr.ac/objects/b40e3572-921d-45d2-85dd-d61e1550e0d9' +++ -今天的文章衔接[上一期](/article/clj3/)有关集合(collection)和序列(sequence)的知识,来讨论一种特殊的集合,叫惰性序列(lazy seq)。我们还会接触到函数式编程(functional programing)。 +今天的文章衔接[上一期](/article/clj3/)有关集合(collection)和序列(sequence)的知识,来讨论一种特殊的集合,叫惰性序列(lazy seq)。我们还会接触到函数式编程(functional programming)。 其实在另一门名为 [Haskell](https://www.haskell.org/) 的语言里,也能见到惰性,而 Haskell 是纯函数式的编程语言(Clojure 在很多方面都不如 Haskell 严格)。函数式和惰性非常契合,可以说没了惰性,函数式就不够务实,会消耗更多的计算资源。<!--more--> ## 编程范式 -编程范式(programming paradigm)可以理解为编程方法论。用我的方法解释的话,一套编程范式提供了一系列高度抽象的逻辑组件、通用的程序结构,比方说 `for` 循环结构就是[结构化编程](https://zh.wikipedia.org/wiki/%E7%BB%93%E6%9E%84%E5%8C%96%E7%BC%96%E7%A8%8B)(structrual programing)这一范式提出的。 +编程范式(programming paradigm)可以理解为编程方法论。用我的方法解释的话,一套编程范式提供了一系列高度抽象的逻辑组件、通用的程序结构,比方说 `for` 循环结构就是[结构化编程](https://zh.wikipedia.org/wiki/%E7%BB%93%E6%9E%84%E5%8C%96%E7%BC%96%E7%A8%8B)(structrual programming)这一范式提出的。 结构化编程的主要主张是 `goto` 语句有害论,由 Dijkstra 在 1968 年提出。这在当时颇有争议,不过如今已成公理,如今的新来者可能根本不会听说 `goto` 语句。我也从来没写过,我了解到 `goto` 的时候,我的 C 语言老师就严肃地告诉我们不该用 `goto`。 -据 Robert C. Martin 在《[架构整洁之道](/library/2026/clean-architecture/#编程范式设计原则和组件原则)》里总结,结构化编程本质是上限制了**程序控制权的直接转移**,即不允许用 `goto` 语句直接变更程序的执行位置。要转移程序的执行位置,只能用**块结构**[^1]表示条件判断、循环体等等。块结构使得程序可以被清晰地划分为可理解的部分,而不是一条一条分散的代码。 +据 Robert C. Martin 在《[架构整洁之道](/library/2026/clean-architecture/#编程范式设计原则和组件原则)》里总结,结构化编程本质上限制了**程序控制权的直接转移**,即不允许用 `goto` 语句直接变更程序的执行位置。要转移程序的执行位置,只能用**块结构**[^1]表示条件判断、循环体等等。块结构使得程序可以被清晰地划分为可理解的部分,而不是一条一条分散的代码。 面向对象编程(object-oriented programing,后称 OOP)在块结构之上提出了新的组织程序的方式,也就是对象(之所以不说「类」,是因为也有无类 OOP,比如[基于原型的编程](https://en.wikipedia.org/wiki/Prototype-based_programming))。程序员经常需要定义一种数据类型,然后定义对这种数据类型的操作(封装);对不同的类型和不同的输入而言,相同的操作可能有不同的行为(多态);数据类型的某些操作是共通的,可以复用(继承)。OOP 引入了更高层的概念和结构。据 Martin 所言,OOP 本质上是限制了对程序控制权的**间接**转移,因为 OOP 用方法(method)代替了函数指针(function pointer)。[^2] @@ -40,11 +40,11 @@ Martin 认为编程范式并没有引入新的东西,反而是提出了更多ç 不过整体而言,FP 并不主流。不少人对 Haskell 的第一印象是「学术语言」(一开始的确是)。Haskell 的标语是「Enjoy long-term maintainable software you can rely on」(享受你可以依靠的长期可维护的软件),这显然是出于工程考虑写下的标语。 -在过去,FP 受到的不认可往往源自于它的性能问题。由于 FP 系统不维护状态,而是在函数的相互调用之间传递参数,循环结构也往往用递归(recursion)表示,这就导致处理大量数据时,函数栈帧会占用大量内存,而且可能出现栈溢出问题。不过这个问题现在已就有了应用广泛的解决方案,叫作尾部调用优化(Tail Call Optimization,TCO)——简单来说,只要递归函数调用发生在函数尾部,编译器或解释器就可以复用上一个递归调用的栈帧,把递归调用变成循环结构,但语言层面仍然是递归写法。 +在过去,FP 受到的不认可往往源自于它的性能问题。由于 FP 系统不维护状态,而是在函数的相互调用之间传递参数,循环结构也往往用递归(recursion)表示,这就导致处理大量数据时,函数栈帧会占用大量内存,而且可能出现栈溢出问题。不过这个问题现在已经有了应用广泛的解决方案,叫作尾部调用优化(Tail Call Optimization,TCO)——简单来说,只要递归函数调用发生在函数尾部,编译器或解释器就可以复用上一个递归调用的栈帧,把递归调用变成循环结构,但语言层面仍然是递归写法。 ## 深入函数式 -FP 不仅禁止赋值语句,还避免副作用(side effectse)。FP 把函数想象成和数学函数一样的东西,输入值,然后输出值,这其间不该发生别的事情,比如不该修改系统中其他的状态。 +FP 不仅禁止赋值语句,还避免副作用(side effects)。FP 把函数想象成和数学函数一样的东西,输入值,然后输出值,这其间不该发生别的事情,比如不该修改系统中其他的状态。 那 FP 程序怎么和外部设备交互呢?照其定义,I/O 操作也是副作用,我还不能把数据写入磁盘了吗?其实,一般只有**纯**函数式语言才会想要完全消除副作用,Haskell 是通过引入 [IO 单子](https://zh.wikipedia.org/wiki/%E5%8D%95%E5%AD%90_(%E5%87%BD%E6%95%B0%E5%BC%8F%E7%BC%96%E7%A8%8B)#IO%E5%8D%95%E5%AD%90%EF%BC%88Haskell%EF%BC%89)的概念消除副作用的。Haskell 把对外部状态的访问和操作当作显式的作用,而非副作用。至于 Clojure,它并不是**纯**函数式语言。副作用是允许的,只是不鼓励。Scheme 也允许副作用,因此 Scheme 更喜欢用 *procedure*(过程)这个词表示 *function*,因为有副作用的不是纯函数。 @@ -224,7 +224,7 @@ public int count(){ 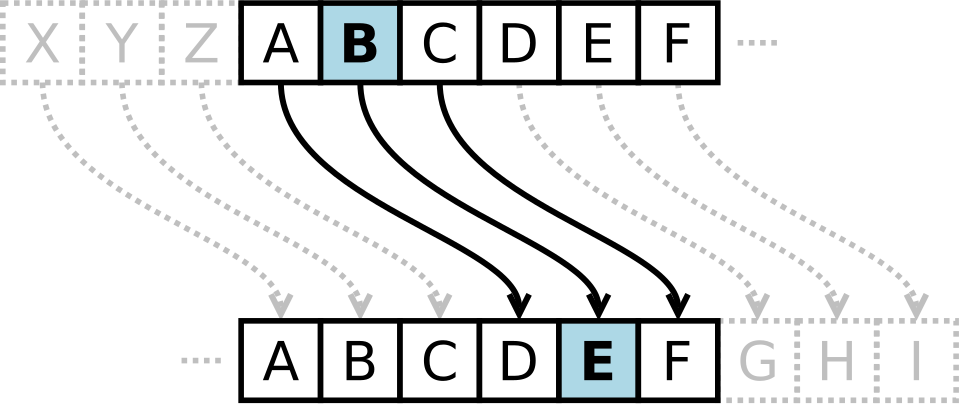 {.dark:invert} -我们知道 ASCII 编码中,`65` 对应的是大写字母 `A`,`90` 对应 `Y`。如果要将 `A` 变成 `D`,只需要对字符的十进制数表示加 3,然后再转换成字符。 +我们知道 ASCII 编码中,`65` 对应的是大写字母 `A`,`90` 对应 `Z`。如果要将 `A` 变成 `D`,只需要对字符的十进制数表示加 3,然后再转换成字符。 在 Clojure 中,可以调用 Java 方法把数字转换为 ASCII 字符串: @@ -339,8 +339,8 @@ public int count(){ (if (seq user-hooks) (select-keys (merge default-hooks user-hooks) - hook-keys)) - default-hooks)) + hook-keys) + default-hooks))) ``` `select-keys` 只选择映射中指定的键,如果用户提供了不存在的键,可以用这个函数筛掉。不过不筛问题也不大,反正多余的钩子也不会被调用。 @@ -416,7 +416,7 @@ public int count(){ [^1]: 比如 C 语言中 `{}` 包裹的块。 -[^2]: 不过我对这个说法存疑,因为 C++ 作为 OOP 语言,甚至有方法指针(method pointerp)这种东西。 +[^2]: 不过我对这个说法存疑,因为 C++ 作为 OOP 语言,甚至有方法指针(method pointer)这种东西。 [^3]: Go 语言的 `channel` 其实用 FP 以外的方式解决了这个问题 diff --git a/content/article/clj5.md b/content/article/clj5.md index 85eb1be7..19f52663 100644 --- a/content/article/clj5.md +++ b/content/article/clj5.md @@ -145,7 +145,7 @@ cd antfighter - 可以在 `:refer` 之后的向量中填写多个符号名。 - 可以把 `:refer` 之后的向量替换成 `:all`,把命名空间中的所有符号引入当前命名空间。不推荐这种写法,需要注意命名冲突。 -其实还有 `:use` 的写法,等同于 `:require [... :refer all]`。`:use` 也可以加上 `:exclude`(排除)和 `:only`(只引入)等参数,但根据 [Clojure Style Guide](https://guide.clojure.style/) 的[讨论](https://github.com/bbatsov/clojure-style-guide/issues/5),现在已经不推荐使用 `:use`,全部换成 `:require` 是最好的。 +其实还有 `:use` 的写法,等同于 `:require [... :refer :all]`。`:use` 也可以加上 `:exclude`(排除)和 `:only`(只引入)等参数,但根据 [Clojure Style Guide](https://guide.clojure.style/) 的[讨论](https://github.com/bbatsov/clojure-style-guide/issues/5),现在已经不推荐使用 `:use`,全部换成 `:require` 是最好的。 至于 `:import`,这是用来引入 Java 库的,这个我们留到之后讲 Clojure 如何与 Java 联动的时候再说。 @@ -228,7 +228,7 @@ Clojure 的 `import` 跟 Java 的差不了太多,`import` 的参数是 Java çš `import` 和 `require` 类似,也可以接收多个向量。每个向量的第一个元素是包名,后面的是可变数量的元素,是 Java 类名。上述代码从 `org.apache.commons.validator.routines` 这个包[^3]里引用了 `UrlValidator` 类。 -顺带一提,Clojure 做的一大改变就是把类和命名空间解耦了。在 Java 中,类既是数据类型,又是命名空间。在 Clojure 创造者 Rich Hickey 的演讲《[Simple Made Easy](https://redirect.invidious.io/watch?v=SxdOUGdseq4)》就提到了这一点。Clojure 的命名空间就只是命名空间而已。 +顺带一提,Clojure 做的一大改变就是把类和命名空间解耦了。在 Java 中,类既是数据类型,又是命名空间。Clojure 的创造者 Rich Hickey 在演讲《[Simple Made Easy](https://redirect.invidious.io/watch?v=SxdOUGdseq4)》中就提到了这一点。Clojure 的命名空间就只是命名空间而已。 除了在 `project.clj` 里声明的外部 Java 库,也可以直接用 Java 标准库里的类。 @@ -298,7 +298,7 @@ date.getMonth() 上述依赖不写在 `:profiles` 里也能用,但运行和编译代码时,都会把实际上并没有在生产代码里用到的依赖打包进去,会消耗额外的资源,因此应该分离。 -此外还有 Leiningen 插件,他们和代码以及测试代码都没有关系,而是用来辅助开发的,写在 `:plugins` 设置项里,格式与依赖相同。下面是我常用的一些插件。 +此外还有 Leiningen 插件,插件和代码以及测试代码都没有关系,而是用来辅助开发的,写在 `:plugins` 设置项里,格式与依赖相同。下面是我常用的一些插件。 ```clojure :plugins [[lein-ancient "0.6.15"] @@ -316,7 +316,7 @@ date.getMonth() 除了命名空间的概念,Clojure 项目的结构和管理方法与其他软件项目并无太多差异。不过我这里说的「管理」并不是针对人力和时间分配的项目管理,而是指对软件的结构和依赖项的管理。 -Clojure 项目比较特殊的是,尽管其他非 Lisp 编程语言可能也有热重载能力,但他们不像 Lisp 的 REPL 那样灵活。REPL 不只能做到热重载,还允许程序员直接与程序对话,快速上手调试。在项目根目录使用 `lein repl` 启动 REPL 和 nREPL,项目里所有的命名空间都会被加载,程序员可以在 REPL 里用 `ns` 在命名空间之间移动,探索软件的内部结构。 +Clojure 项目比较特殊的是,尽管其他非 Lisp 编程语言可能也有热重载能力,但不像 Lisp 的 REPL 那样灵活。REPL 不只能做到热重载,还允许程序员直接与程序对话,快速上手调试。在项目根目录使用 `lein repl` 启动 REPL 和 nREPL,项目里所有的命名空间都会被加载,程序员可以在 REPL 里用 `ns` 在命名空间之间移动,探索软件的内部结构。 既然我们已经掌握了不少 Clojure 的基础知识和项目管理工具,那么是时候来点实操了。下一期我们将会接触到 Ring 及相关的工具,开发简单的 Web 后端。 diff --git a/content/article/give-no-shit-about-llm.md b/content/article/give-no-shit-about-llm.md new file mode 100644 index 00000000..675510aa --- /dev/null +++ b/content/article/give-no-shit-about-llm.md @@ -0,0 +1,10 @@ ++++ +title = '我不再关心语言模型' +subtitle = '我真的累了' +slug = '' +tags = [] +categories = '' +date = 2026-10-04T00:45:31+08:00 +draft = true +toc = true ++++ |