1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
286
287
288
289
290
291
292
293
294
295
296
297
298
299
300
301
302
303
304
305
306
307
308
309
310
311
312
313
314
315
316
317
318
319
320
321
322
323
324
325
326
327
328
329
330
331
332
333
334
335
336
337
338
339
340
341
342
343
344
345
346
347
348
349
350
351
352
353
354
355
356
357
358
359
360
361
362
363
364
365
366
367
368
369
370
371
372
373
374
375
376
377
378
379
380
381
382
383
384
385
386
387
388
389
390
391
392
393
394
395
396
397
398
399
400
401
402
403
404
405
406
407
408
409
410
411
412
413
414
415
416
417
418
419
420
421
422
423
424
425
|
+++
title = 'Coffee Break Clojure, Functional'
subtitle = 'Functionally Lazy'
slug = 'clj4'
tags = ["Lisp","Clojure","编程"]
categories = '茶歇蔻芥'
date = 2026-09-29 21:42:08
draft = false
toc = true
endnotes = [
'最后一节的练习题参考了 [ClojureDocs](https://clojuredocs.org/) 上的示例代码。'
]
fedi = 'https://akk.eltr.ac/objects/b40e3572-921d-45d2-85dd-d61e1550e0d9'
+++
今天的文章衔接[上一期](/article/clj3/)有关集合(collection)和序列(sequence)的知识,来讨论一种特殊的集合,叫惰性序列(lazy seq)。我们还会接触到函数式编程(functional programming)。
其实在另一门名为 [Haskell](https://www.haskell.org/) 的语言里,也能见到惰性,而 Haskell 是纯函数式的编程语言(Clojure 在很多方面都不如 Haskell 严格)。函数式和惰性非常契合,可以说没了惰性,函数式就不够务实,会消耗更多的计算资源。<!--more-->
## 编程范式
编程范式(programming paradigm)可以理解为编程方法论。用我的方法解释的话,一套编程范式提供了一系列高度抽象的逻辑组件、通用的程序结构,比方说 `for` 循环结构就是[结构化编程](https://zh.wikipedia.org/wiki/%E7%BB%93%E6%9E%84%E5%8C%96%E7%BC%96%E7%A8%8B)(structrual programming)这一范式提出的。
结构化编程的主要主张是 `goto` 语句有害论,由 Dijkstra 在 1968 年提出。这在当时颇有争议,不过如今已成公理,如今的新来者可能根本不会听说 `goto` 语句。我也从来没写过,我了解到 `goto` 的时候,我的 C 语言老师就严肃地告诉我们不该用 `goto`。
据 Robert C. Martin 在《[架构整洁之道](/library/2026/clean-architecture/#编程范式设计原则和组件原则)》里总结,结构化编程本质上限制了**程序控制权的直接转移**,即不允许用 `goto` 语句直接变更程序的执行位置。要转移程序的执行位置,只能用**块结构**[^1]表示条件判断、循环体等等。块结构使得程序可以被清晰地划分为可理解的部分,而不是一条一条分散的代码。
面向对象编程(object-oriented programing,后称 OOP)在块结构之上提出了新的组织程序的方式,也就是对象(之所以不说「类」,是因为也有无类 OOP,比如[基于原型的编程](https://en.wikipedia.org/wiki/Prototype-based_programming))。程序员经常需要定义一种数据类型,然后定义对这种数据类型的操作(封装);对不同的类型和不同的输入而言,相同的操作可能有不同的行为(多态);数据类型的某些操作是共通的,可以复用(继承)。OOP 引入了更高层的概念和结构。据 Martin 所言,OOP 本质上是限制了对程序控制权的**间接**转移,因为 OOP 用方法(method)代替了函数指针(function pointer)。[^2]
Martin 认为编程范式并没有引入新的东西,反而是提出了更多的限制,比如限制 `goto` 语句和限制函数指针。函数式编程(后称 FP)范式引入的限制是:禁止赋值语句。是的,==不允许给变量赋值==,所以在前四篇里我们一次都没有见到 Clojure 的赋值语句,只见到了定义符号的语句。
为什么?因为给变量赋值就意味着我们在维护一个**可变的状态**,而状态在 FP 看来是个坏东西:
1. 如果系统有多个状态,复现 Bug 时,需要复原系统中所有的状态。
2. 有多个读者和写者时,为保证数据一致性和完整性,需要加锁,而维护锁很痛苦[^3]。更何况锁本身也是一个新的状态!
- 说到这里,容许我插一嘴,我前不久修复了一个非常诡异的 Bug,最后我们发现问题出在系统里某个地方加了锁。这个锁是外部的某个库引入的,我们完全不知道那个锁的存在。当时系统出现了大量的超时错误,我们以为是网络阻塞,结果竟然是大量请求等待锁导致的。
3. 管理状态如何在系统的各个部分之间同步和转移,定义状态如何变更,检验状态的有效性等等,都会极大提升系统的复杂度。
这其实也在逐渐成为共识,我们看到很多编程语言(比如 Rust)的变量默认不可变(immutable)。状态更少会让复杂系统更容易维护,而 FP 则致力于消除可变状态。
不过整体而言,FP 并不主流。不少人对 Haskell 的第一印象是「学术语言」(一开始的确是)。Haskell 的标语是「Enjoy long-term maintainable software you can rely on」(享受你可以依靠的长期可维护的软件),这显然是出于工程考虑写下的标语。
在过去,FP 受到的不认可往往源自于它的性能问题。由于 FP 系统不维护状态,而是在函数的相互调用之间传递参数,循环结构也往往用递归(recursion)表示,这就导致处理大量数据时,函数栈帧会占用大量内存,而且可能出现栈溢出问题。不过这个问题现在已经有了应用广泛的解决方案,叫作尾部调用优化(Tail Call Optimization,TCO)——简单来说,只要递归函数调用发生在函数尾部,编译器或解释器就可以复用上一个递归调用的栈帧,把递归调用变成循环结构,但语言层面仍然是递归写法。
## 深入函数式
FP 不仅禁止赋值语句,还避免副作用(side effects)。FP 把函数想象成和数学函数一样的东西,输入值,然后输出值,这其间不该发生别的事情,比如不该修改系统中其他的状态。
那 FP 程序怎么和外部设备交互呢?照其定义,I/O 操作也是副作用,我还不能把数据写入磁盘了吗?其实,一般只有**纯**函数式语言才会想要完全消除副作用,Haskell 是通过引入 [IO 单子](https://zh.wikipedia.org/wiki/%E5%8D%95%E5%AD%90_(%E5%87%BD%E6%95%B0%E5%BC%8F%E7%BC%96%E7%A8%8B)#IO%E5%8D%95%E5%AD%90%EF%BC%88Haskell%EF%BC%89)的概念消除副作用的。Haskell 把对外部状态的访问和操作当作显式的作用,而非副作用。至于 Clojure,它并不是**纯**函数式语言。副作用是允许的,只是不鼓励。Scheme 也允许副作用,因此 Scheme 更喜欢用 *procedure*(过程)这个词表示 *function*,因为有副作用的不是纯函数。
与副作用相关的概念是引用透明性([referential transparency](https://en.wikipedia.org/wiki/Referential_transparency)),可以说避免副作用就是为了实现引用透明性。以下面这段 Clojure 代码为例:
```clojure
(+ (- 3 1) 4)
;; => 6
;; 上述代码应该和下面这段代码等价
(+ 2 4)
;; => 6
;; 上述代码应该和下面这段代码等价
6
;; => 6
```
==函数调用可以显式地替换为它的返回值==,这就是引用透明性。对数学运算来说这理所应当,FP 要求的就是把这种「理所应当」也应用在其他计算机程序上。没有引用透明性的函数是什么样的?
```js
var x = 0
function add(a, b) {
x = x + 1
return a + b
}
add(add(x, x), x)
// => 1
```
上述 `add()` 是个闭包函数(因为它访问了外部作用域的 `x` 变量),每执行一次 `add()` 都悄悄地给 `x` 加 `1`,然后再返回 `a + b`。
执行 `add(add(x, x), x)` 的结果是 `1`。调用最外层的 `add()` 之前,我们先要得到参数的值。第一个参数是函数调用,求出值为 `0`,同时 `x` 的状态变成了 `1`[^4];然后将 `0` 作为第一个参数传入,此时求 `x` 的值,发现是 `1`,将 `1` 作为第二个参数传入,也就是 `add(0, 1)`。最后函数返回了 `1`,`x` 的值变成了 `2`。
假设现在 `x` 的值还是 `0`,我们把 `add(x, x)` 换成理应等价的 `0`,发现 `add(0, x)` 得到的是 `0` 而不是 `1`。这个程序没有引用透明性,而且 `x` 的状态不可控,`add()` 的结果难以预测。
不难意识到避免副作用对系统的长期可维护性的好处。如果我们非要一个 `x` “变量”作为计数器,记录调用 `add()` 函数的次数,不妨用递归实现。
```js
const numbers = [2, 4, 3, 7, 2, 7, 5, 10, 3]
function addWithCounter(numbers, counter, total, index) {
if (numbers.length - 1 < index) {
return {counter: counter, total: total}
}
return addWithCounter(numbers, counter+1, total + numbers[index], index+1)
}
addWithCounter(numbers, 0, 0, 0)
// => {counter: 9, total: 43}
```
上面这段代码是函数式的。`const` 是常量声明,而不是赋值。在 `addWithCounter()` 中我们只是返回计算后的值,将某些“状态”作为函数参数递归地传递,没有可变状态。我们在不使用循环结构的情况下遍历累加了数组,并且维护了一个 `counter`(计数器)。
在 Clojure 中,可以用 `loop` 构造递归,无需声明函数:
```clojure
(defn addWithCounter [numbers]
(loop [counter 0, total 0, index 0]
(if (< (count numbers) (inc index))
{:counter counter :total total}
(recur (inc counter) (+ total (numbers index)) (inc index)))))
(addWithCounter [1 2 3])
;; => {:counter 3, :total 6}
```
不过更好的写法是用利用惰性。
```clojure
;; reductions 类似于 reduce
;; 但返回的是每个步骤的 lazy seq,而不是最终结果
;; (= (reduce f coll) (last (reductions f coll)))
(defn addWithCounter [numbers]
(let [steps (reductions + numbers)]
{:counter (count steps)
:total (last steps)}))
(addWithCounter [1 2 3])
;; => {:counter 3, :total 6}
```
`reductions` 函数返回的是惰性序列,其实上一篇提到的 `map` 返回的也是惰性序列。这究竟是什么东西?
## 初识惰性
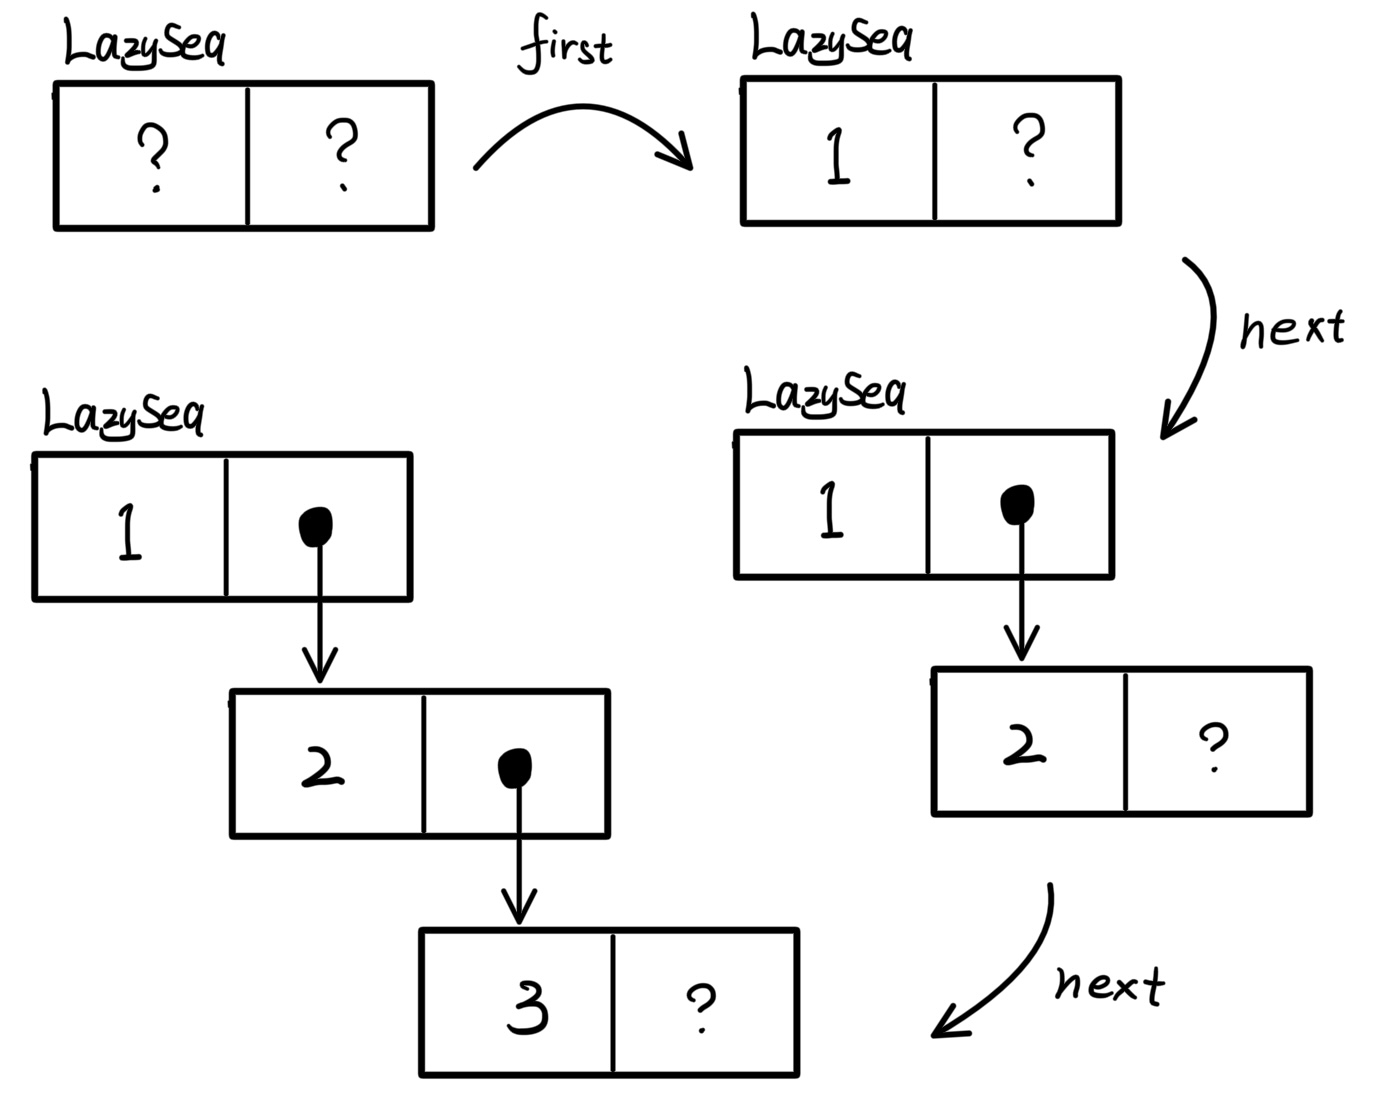
`lazy-seq` 函数接收一系列表达式,这些表达式最终返回一个序列。不过,写在 `lazy-seq` 里面的表达式并不会被立即执行,而是会在 `lazy-seq` 被访问时执行。也就是说,`lazy-seq` 保存了一系列「如何求值」的步骤,仅在每个步骤被访问时才计算具体的数值。
还记得序列(sequence)的定义吗?仅支持线性访问的集合。还记得 Cons 吗?一个序列就是保存了第一个值(`_first`)和指向下一个 Cons 的“指针”(`_next`)的对象。假如序列的 `next` 并不指向下一个 Cons,调用它的 `next()` 方法时,它并不 `return _next`,而是调用函数计算下一个值再返回,调用几次 `next()` 就计算几次值。
听起来像个迭代器(Iterator),两者确实很像。惰性序列就是可以当作序列处理的迭代器,不过我们并不需要手动调用 `next`,只需要正常地把它当作序列处理,剩下的 Clojure 会帮我们解决。
{.dark:invert}
作为演示,我们先定义一个指向无穷的符号。
```clojure
(def ∞ (range))
;; => #'user/∞
(type ∞)
;; => clojure.lang.Iterate
```
`range` 可以返回指定范围的整数序列,如果不给参数的话,就会返回 `Iterate` 对象。可以把 `Iterate` 理解为做了特殊优化的 `LazySeq`,使用起来和惰性序列区别不大。
我们试试从「无穷」中取出前五个数:
```clojure
(take 5 ∞)
;; => (0 1 2 3 4)
```
只想要正整数?没问题。
```clojure
(def ℤ (map inc ∞))
;; => #'user/ℤ
(take 5 ℤ)
;; => (1 2 3 4 5)
```
只想要偶数?当然!
```clojure
;; 其实我本来想用 {2k|k∈ℤ} 做符号名,可惜不合法
(def even-numbers (filter even? ℤ))
;; => #'user/even-numbers
;; or
(def even-numbers (map #(* 2 %) ℤ))
;; => #'user/even-numbers
(take 5 even-numbers)
;; => (2 4 6 8 10)
```
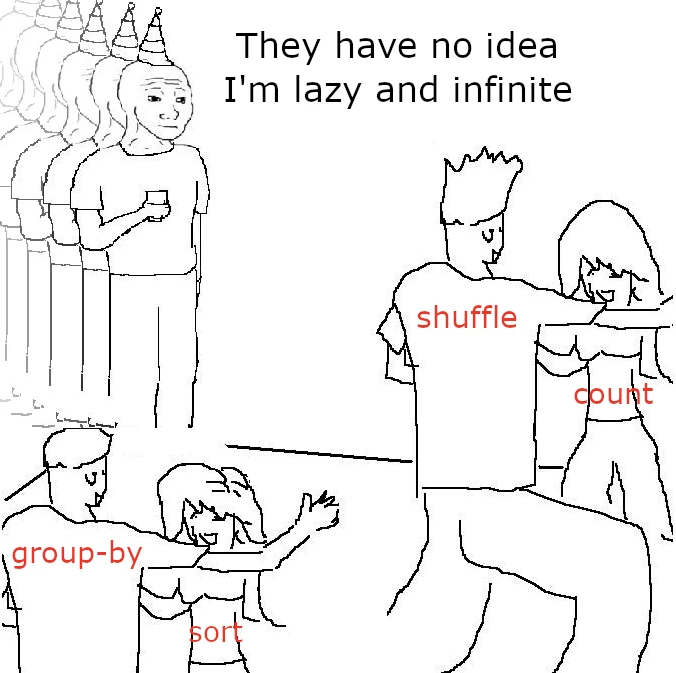
但要注意,有些操作不能应用在无穷的惰性序列上,比如 `shuffle`,这个函数的作用是打乱一个序列,但你怎么打乱「无穷」呢?想想就需要无穷的计算时间。此外还有 `sort`、`group-by` 和 `count`。
{.dark:invert}
等等,`count`?难道之前不是说 `count` 的时间复杂度为 `O(1)`,只需要 `return _count` 就好了吗?对惰性序列来说不是这样,因为在把所有可能性都实现之前,惰性序列自己也不知道自己有多长。
```java
// package clojure.lang
// LazySeq 的 count 方法
public int count(){
int c = 0;
for(ISeq s = seq(); s != null; s = s.next())
++c;
return c;
}
```
惰性序列和迭代器的另一个区别是,惰性序列会缓存已经计算的值,再次访问时会使用已有的值,不会重复计算。可以用 `realized?` 函数检查序列有没有被计算。
```clojure
(realized? (range))
;; => true
(realized? (rest (range)))
;; => false
```
`(range)` 本身作为一个 Cons,包含 `0` 的初始值,但它之后的 Cons 都还没有被计算,所以返回 `false`。注意 `(realized? (first (range)))` 实际上是 `(realized? 0)`,会报错,因为 `Long` 类型没有是否被实现之分。
## 练习函数式与惰性
接下来我会提出一些需求,读者可以在自己的 REPL 里编写 Clojure 代码实现,我会把参考答案附在题目后面。题目中还会包含一些新的 Clojure 函数的用法介绍,读者可以一边练习一边学习新函数。
### 凯撒密码
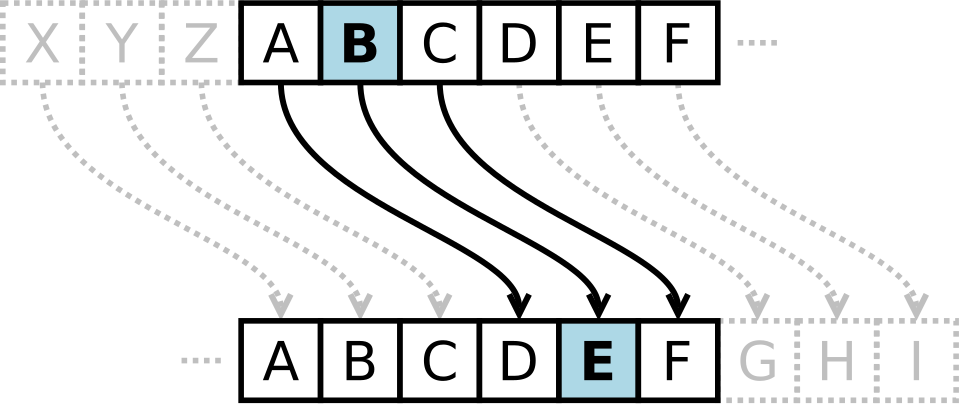
凯撒密码是一种替换加密,即简单地把明文中的每个字母替换为字母表往后偏移 N 个字母之后的字母。比如,如果偏移量是 3,`A` 就会被换成 `D`。
{.dark:invert}
我们知道 ASCII 编码中,`65` 对应的是大写字母 `A`,`90` 对应 `Z`。如果要将 `A` 变成 `D`,只需要对字符的十进制数表示加 3,然后再转换成字符。
在 Clojure 中,可以调用 Java 方法把数字转换为 ASCII 字符串:
```clojure
(Character/toString 65)
;; => "A"
(Character/toString (+ 65 3))
;; => "D"
```
可以用 `zipmap` 函数把两个序列封装成映射,第一个序列的元素作为键,第二序列的元素作为值。
```clojure
(zipmap ["A" "B" "C"] ["D" "E" "F"])
;; => {"A" "D", "B" "E", "C" "F"}
```
`range` 可以指定序列的范围:
```clojure
(range 65 91)
;; => (65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90)
```
使用 `range`、`map` 和 `zipmap` 构造出偏移量为 `5` 的凯撒密码对照表。
<details>
<summary>参考答案</summary>
```clojure
(defn caesar-map [offset]
(let [alphabet (map Character/toString (range 65 91))
ciphered (concat (drop offset alphabet)
(take offset alphabet))]
(zipmap alphabet ciphered)))
```
```clojure
(caesar-map 5)
;; => {"T" "Y", "K" "P", "Q" "V", "L" "Q", "G" "L", "J" "O", "M" "R", "S" "X", "Y" "D", "Z" "E", "H" "M", "E" "J", "R" "W", "C" "H", "F" "K", "B" "G", "P" "U", "V" "A", "U" "Z", "O" "T", "X" "C", "N" "S", "A" "F", "I" "N", "W" "B", "D" "I"}
(get (caesar-map 5) "A")
;; => "F"
```
</details>
### 钩子
系统的业务逻辑里有几个关键节点设置了钩子,在特定事件发生时可以执行用户自定义的函数,像这样:
```clojure
(defn process-large-data [hooks data]
(let [todo (map process-data (filter valid? data))]
(if (seq todo)
;; todo 非空的时候,执行 todo
;; 然后调用 hooks 里的 :on-finish 函数
(do (doall todo)
((:on-finish hooks)))
;; todo 为空,即没有要处理的数据
;; 调用 hooks 里的 :on-empty 函数
((:on-empty hooks)))))
```
`todo` 是 `filter` 和 `map` 返回的惰性序列,如果没有被访问就不会执行 `process-data`。之后通过 `seq` 检查 `todo` 是否**非空**,如果是的话就 `doall`,这个函数可以执行惰性序列中所有的元素。外层的 `do` 用来把多个表达式放在一个形式(form)里,不然会被 `if` 当作多个参数处理。
`hooks` 是长这样的映射。
```clojure
{:on-finish (fn [] (println "Finished processing"))
:on-empty (fn [] (println "Todo is empty"))}
```
`(:on-finish hooks)` 把函数从映射里取出来,`((:on-finish hooks))` 先把函数取出来,然后执行这个函数。
可以使用 `merge` 函数将两个映射合并,如果有相同的键,用后一个映射覆盖:
```clojure
(merge {:a 1 :b 2 :c 3} {:a 2 :b 1})
;; => {:a 2, :b 1, :c 3}
```
`repeat` 函数返回重复同一个值的序列,如果不指定重复的次数,就会返回无限长的惰性序列。
```clojure
(repeat 5 "hello")
;; => ("hello" "hello" "hello" "hello" "hello")
(take 5 (repeat "hello"))
;; => ("hello" "hello" "hello" "hello" "hello")
(repeat "hello")
;; 如果直接访问这个惰性序列
;;(比如:在 REPL 里输入,REPL 会 print 这个序列)
;; 就会造成死循环,(range) 也是同理
```
使用 `merge`、`repeat` 和 `zipmap` 编写 `make-hooks` 函数,接收 `user-hooks` 参数,`user-hooks` 和上文的 `hooks` 结构相同,但键可能不全。默认情况下,`hooks` 中的钩子函数不做任何操作(`println` 也不能有),除非用户传入了钩子函数。
<details>
<summary>参考答案</summary>
```clojure
(def hook-keys [:on-finish :on-empty])
(def default-hooks
(zipmap hook-keys (repeat (fn []))))
(defn make-hooks
([] default-hooks)
([user-hooks]
(if (seq user-hooks)
(select-keys
(merge default-hooks user-hooks)
hook-keys)
default-hooks)))
```
`select-keys` 只选择映射中指定的键,如果用户提供了不存在的键,可以用这个函数筛掉。不过不筛问题也不大,反正多余的钩子也不会被调用。
</details>
### 无重复的随机数序列
`repeat` 函数重复值,`repeatedly` 函数可以重复执行函数,返回惰性序列。`(rand-int n)` 返回 `[0, n)` 区间内的随机整数。[^5]
```clojure
(take 5 (repeatedly #(rand-int 100)))
;; => (72 56 54 21 89)
```
`loop` 和 `recur` 刚才我们已经见过了。可以把 `loop` 里类似 `let` 绑定的向量当作函数的参数和初始值之间的绑定,而 `recur` 则是递归地调用 `loop`,`recur` 的参数数量应该和 `loop` 的绑定数量相同。
```clojure
(loop [arg1 0, arg2 "any value" arg3 :not-over]
(if (> arg1 10)
{:arg1 arg1 :arg2 arg2 :arg3 :over}
(recur (inc arg1) "any value" :not-over)))
;; => {:arg1 11, :arg2 "any value", :arg3 :over}
```
使用任何你能想到的函数,编写 `uniquely-rand-int` 函数,接收参数 `n` 和 `t`,返回由 `n` 个小于 `t` 的**不重复**的随机整数序列。
<details>
<summary>参考答案</summary>
第一种解法,使用 `loop` 并拒绝已经存在的元素。
```clojure
(defn uniquely-rand-int [n t]
(loop [result '()]
(if (>= (count result) n)
result
(let [randint (rand-int t)]
(if (some #{randint} result)
(recur result)
(recur (conj result randint)))))))
```
第二种解法,使用 `set`,利用集的特性去重。
```clojure
(defn uniquely-rand-int [n t]
(loop [result #{}]
(if (>= (count result) n)
(seq result)
(recur (conj result (rand-int t))))))
```
第三种解法:
```clojure
(defn uniquely-rand-int [n t]
(->> (range t) shuffle (take n)))
```
第三种解法不仅更简洁,而且不会出现死循环。试一试,如果是前两种解法,在 `t` 比 `n` 小的情况下就会出现死循环,但第三种解法只会返回数量不足的序列。
```clojure
(uniquely-rand-int 5 10)
;; => (6 8 1 3 9)
(uniquely-rand-int 5 1)
;; => (0)
```
而且第三种解法的时间复杂度是 `O(n)`,瓶颈主要在 `shuffle`,这个函数底下用的是 Java 的 `Collections.shuffle`,[时间复杂度为 `O(n)`](https://zetcode.com/java/collections-shuffle/#:~:text=The%20time%20complexity%20is%20O(n)%20where%20n%20is%20the%20list%20size.)。
</details>
[^1]: 比如 C 语言中 `{}` 包裹的块。
[^2]: 不过我对这个说法存疑,因为 C++ 作为 OOP 语言,甚至有方法指针(method pointer)这种东西。
[^3]: Go 语言的 `channel` 其实用 FP 以外的方式解决了这个问题
[^4]: 为什么这个 `add(x, x)` 没有受到 `x = 1` 的影响?因为函数的参数是作为**值**传入的,不是变量引用。`add()` 接收到的就是两个 `0` 而不是两个 `x`。
[^5]: 你可能注意到了:是的,`rand-int` 不具有引用透明性,不是函数式的,除非确定种子。
|
