1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
|
+++
title = '声势浩大的知识产权盗窃'
subtitle = 'The Great Theft'
slug = 'the-great-theft'
tags = ["AI","开源","Copyleft"]
categories = '软件杂谈'
date = 2026-10-26 13:41:18
draft = false
toc = true
fedi = 'https://akk.eltr.ac/objects/254c3101-7d43-40fb-9f77-26358fc113cd'
+++
之所以说「声势浩大」,是因为我成语储备不够,找不到「不要脸」的文雅说法。<!--more-->
## 蛛丝马迹
这几天我停用了 NetCup 的一台机子,换到了 SKRIME,装了 OpenBSD 系统愉快地玩了起来。结果,正好赶上 [eMudhra 根证书密钥泄露](https://emudhra.we-have-a-problem.com/)[^1]和 [PHP2Shell](https://en.wikipedia.org/wiki/PHP2Shell) 漏洞,于是赶紧在几台机器上更新 `ca-certificates`,手动移除泄露的根证书。
然后我在其中一台机器上执行了 `htop`。
“奇怪,我 VPS 上跑的服务 CPU 占用都应该很低才对,为什么现在涨到 60% 了?”当时的我光顾着四处更新证书和排查漏洞,便没有细想。再后来,我给那台新机子装上了 [beszel-agent](https://github.com/henrygd/beszel) 配置监控和告警,瞟了一眼那台怪怪的机器——“我去,负载怎么红了?”从监控页面上来看,CPU 占用最高的容器是我的 Forgejo 实例。怪了,就算是我在编译软件,~~那 CPU 早该爆满了~~也应该是 Forgejo Runner 容器占用高才对。
前几天我的 Continuwuity 实例突然暴毙,数据库也挂了,还得运行紧急修复,当时发现磁盘已经写满了。当时以为是 Akkoma 数据库没清理,毕竟我联邦的实例确实很多,跑了些基本的清理任务就没管了。可几天后,同样的事情又再次发生了。我扫描了一遍 `/var` 和 `/home`,才发现占满我磁盘的是 `Forgejo` 的 `repo-archive` 目录。
等等,那是什么东西?
> these are archives that can be created for any reference (tags, commits, branches, …) if you don't use them, I would recommend to disable them on a public facing gitea/foregejo instance since they seem to be very popular among scrapers.
>
> 这些是可以给任何引用(tag、commits、branch……)创建的归档文件。如果你不用的话,我建议在公开的 gitea/forgejo 实例上禁用,因为好像爬虫很爱爬。
{{< right "——[一位路过的热心 Fedi 网友](https://microblog.shivering-isles.com/users/sheogorath/statuses/117481967835781126)" >}}
Forgejo 作为 Git 服务器,可以给各个版本的仓库创建无 Git 历史的 `.zip` 和 `.tar.gz` 压缩包。一般只有用户尝试下载,Forgejo 才会打包,打包之后就缓存在磁盘上。由于爬虫会贪婪地抓取网站上的每一个链接,所以几乎每个 commit、分支和版本的压缩包都被缓存到了磁盘上。
我立马关掉了这个功能,在考虑要不要架设 [Anubis](https://anubis.techaro.lol/) 或者调整 WAF 规则,可还没等我来得及想清楚,我就发现那些爬虫仍然穷追不舍。
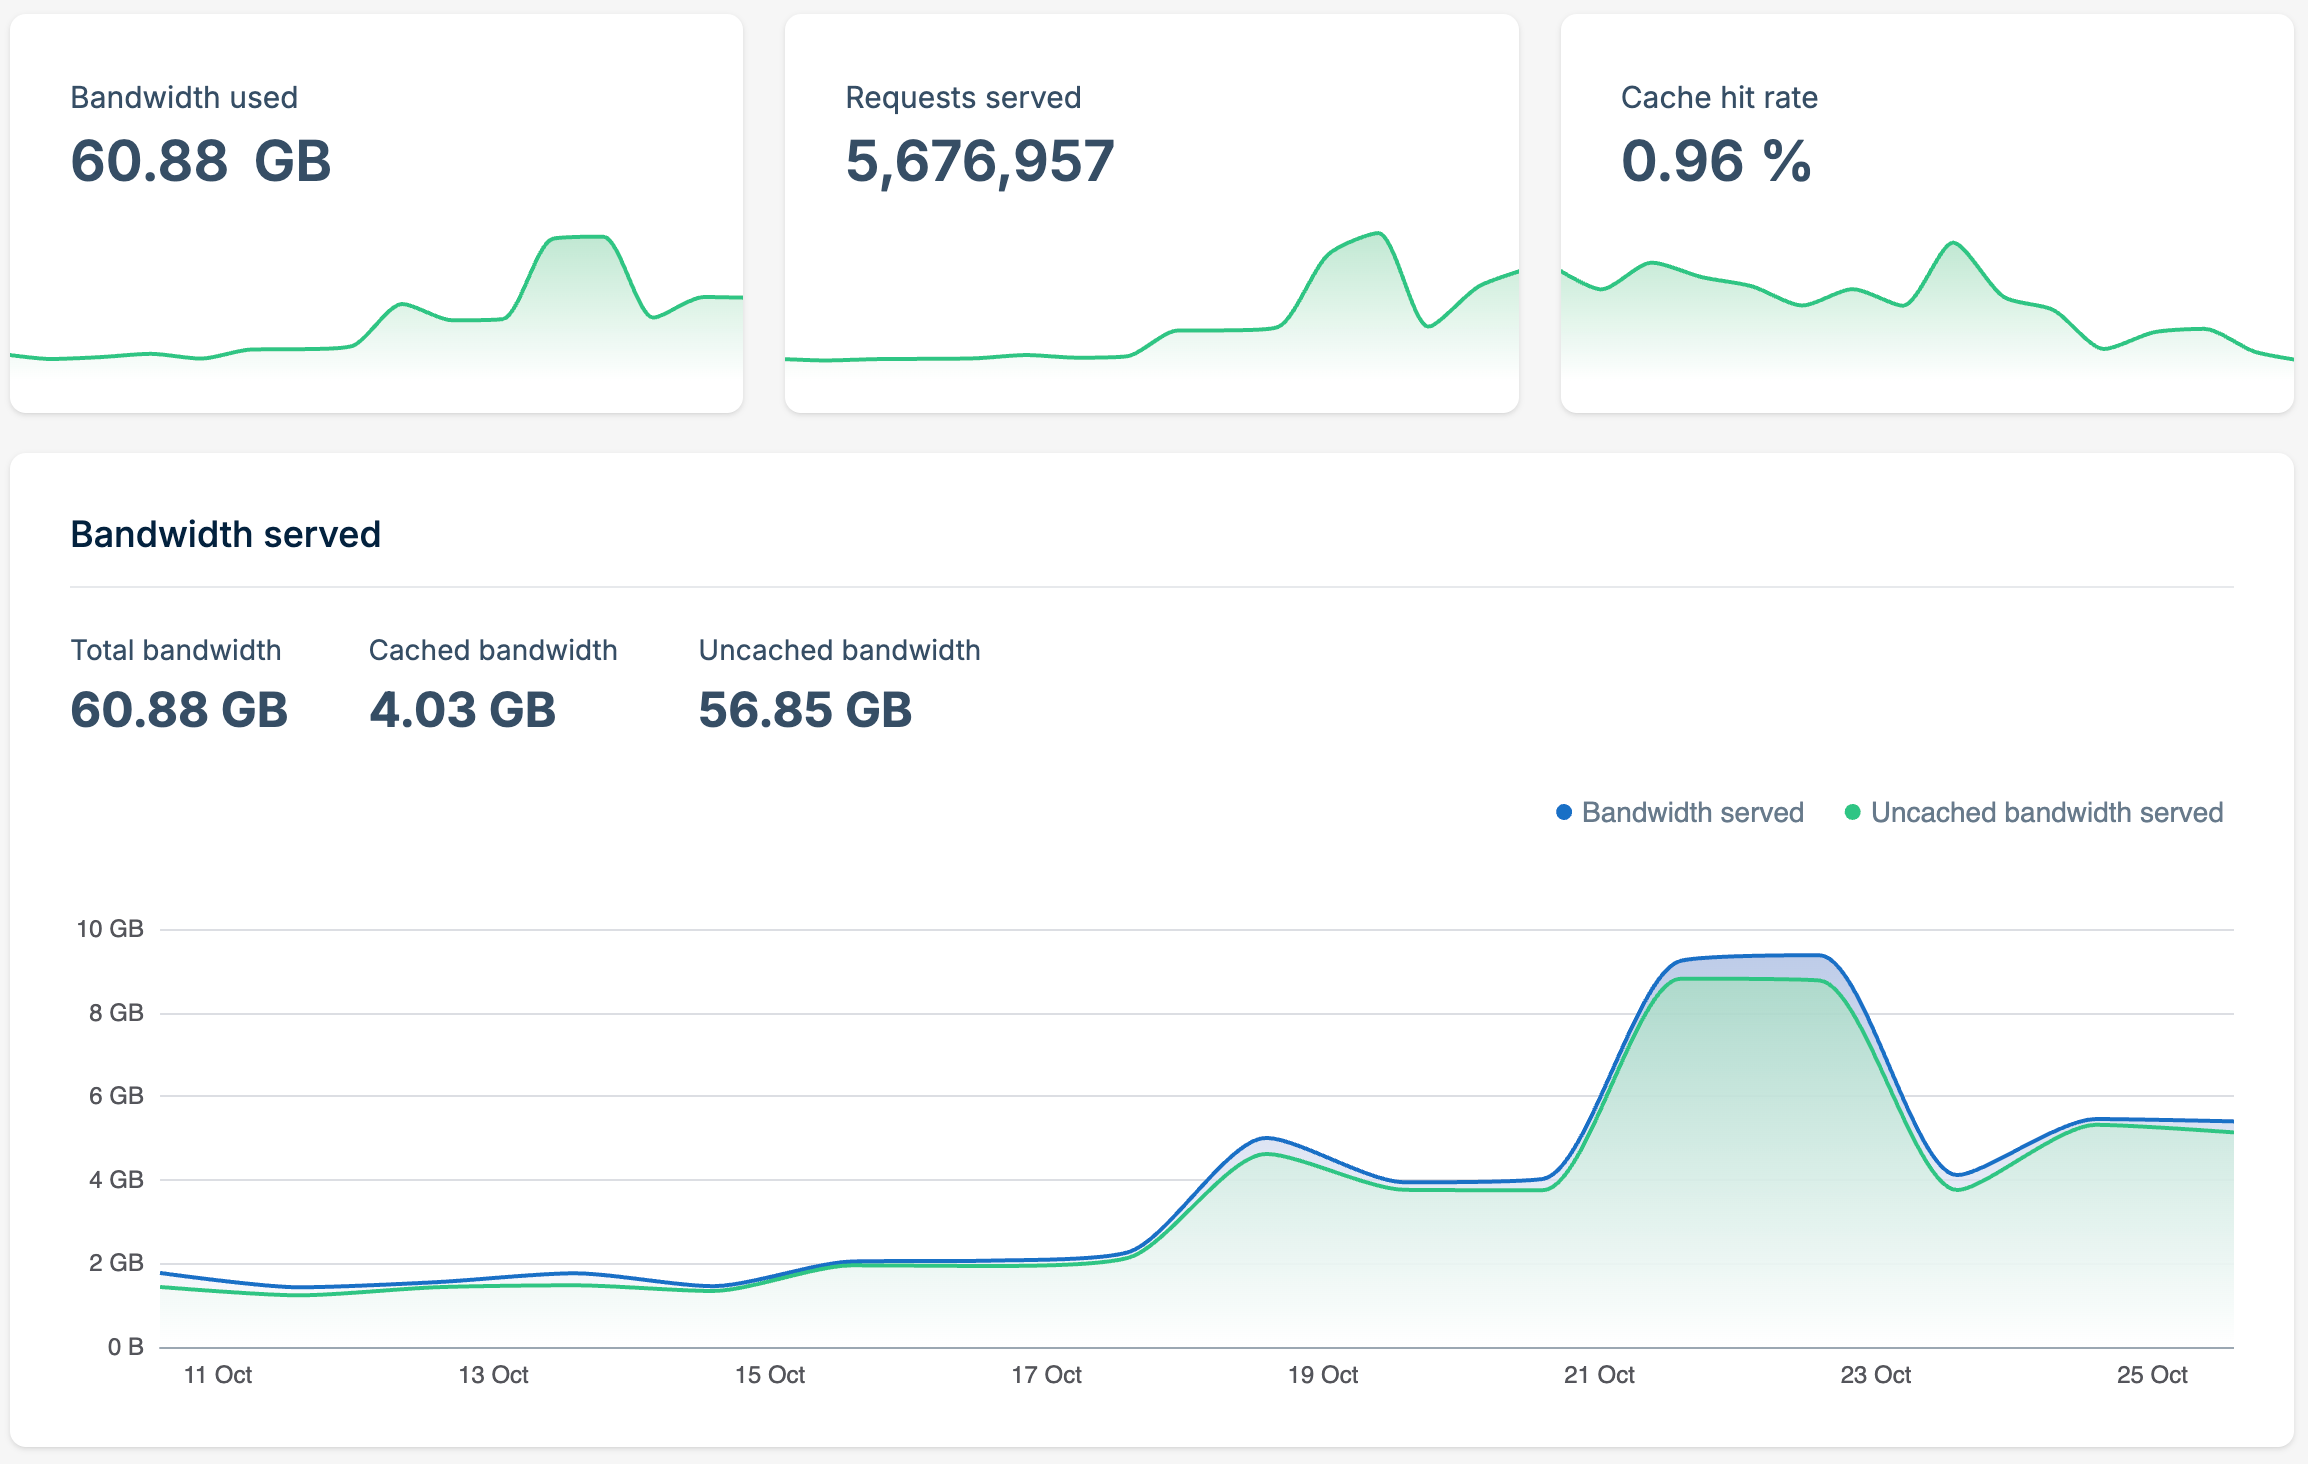
可以看到十月 21 日起,宽带用量异常上升,而十月 23 日,也就是我关掉 Forgejo 打包功能的不久后,宽带用量有所下降,但依旧高得不正常。
与此同时,我的 CPU 占用依旧居高不下。
我尝试把 WAF 规则调到最严格的那档,效果仅仅是让我自己加载不出 Forgejo 的 JavaScript 脚本,而爬虫还在猖狂地进攻,对我的反爬措施完全不为所动。说句玩笑话,蝗虫入侵估计也就就这个场面吧。
我想,既然 CPU 能扛住,我的其他服务也照常运行,何不就此装上 [Iocaine](https://iocaine.madhouse-project.org/),给大语言模型下毒呢?
我的确装上了 Iocaine,不过,从统计数据来看,命中规则的只有…… 一个爬虫。剩下的请求数量,数字位数太大我已经懒得数,可能来自几家(甚至同一家)如饥似渴地想要拿到真人产出的训练数据的模型公司,但因为太会伪装,所以 Iocaine 默认的规则已经无法分辨——等等,你们这个[默认规则](https://raw.githubusercontent.com/ai-robots-txt/ai.robots.txt/refs/heads/main/robots.json)就仅仅是匹配 User-Agent 而已吗!?这个谁绕不开啊?
此外我还发现了一个严重的问题,我的 CDN 账单真在肉眼可见地上涨,我是没钱跟这些没有道德底线的科技公司闹的。
## I did it the Linux Kernel way
Linux 内核管理者 Konstantin Ryabitsev 今年八月底发了一篇[文章](https://people.kernel.org/monsieuricon/creepy-crawlies)。众所周知,Linux 内核的源代码在他们自己管理的 `git.kernel.org` 上,而这上面除了人类手写[^2]的新鲜代码,还有邮件列表里人类产出的新鲜对话。这对 LLM 爬虫来说可相当诱人。
想都不用想,他们的情况只会更糟:
> At any one time, across 5 geo-distributed nodes, there are 14 CPU cores doing nothing but rendering git commits as html.
>
> 在任何时间,横跨五个地区分布的节点,有 14 个 CPU 核心除了把 git commit 渲染成 HTML 页面以外什么也没做。
而 `git clone` 占用的才不过 10 个 CPU 核心,爬虫消耗的资源已经超过了真实用户消耗的资源。
他们的做法是用 Anubis 挡住,随着爬虫一波又一波地来,他们也一次又一次地提高 PoW 的难度,尽量让爬虫的每次请求都消耗更长的时间,也消耗它们的 CPU 资源。用户怨声载道,因为难度高了,真实用户的设备解起来也很慢,很多移动设备的 CPU 较差,甚至会发热。
但是这也没有挡住爬虫。
爬虫一直在用最蠢的方式爬 `git.kernel.org`——访问每一个版本、每一个分支的 commit 页面。不直接把代码克隆下来,就要爬混杂着无用 HTML 的代码,顶着 Anubis 的资源消耗也要硬爬。
最后他们无奈,只能关掉了 commit 页面的渲染。
我也只能这么做了:
```Caddyfile
# block commit urls
@blockCommit path */commit/*
respond @blockCommit "Due to relentless LLM scrapers, I have turned off commits urls. Clone the repository if you must." 200
```
顺带一提,我把状态码设置成了 `200`,这样爬虫就会以为他们成功爬取到内容了。希望你们喜欢清洗数据。
## 无止尽的猫鼠游戏
其实我很早之前就做了 *Cookie Monster* 验证,也就是默认拒绝所有请求,返回空壳页面。空壳页面里带 `<script>` 标签,脚本做的事情就是帮用户设置一个 Cookie,然后刷新页面。带有这个 Cookie 的请求不会被拒绝。
这种做法利用的是大部分爬虫不会执行 JavaScript,就算执行也不会开启 Cookies 的特性。Iocaine 默认除了 `User-Agent` 验证,还做了浏览器特征识别,但现在用无头浏览器的爬虫也到处都是了,并不稀奇。显然,这一波蝗虫轻而易举地越过了这些简单的反爬措施,持续攻击我的 CPU。
我现在做的工作也是爬虫相关的[^3],所以对反爬与规避反爬的猫鼠游戏有相当程度的了解。还好我司的业务并不包含训练模型,爬虫是做别的事情用的,这才不至于让我良心难安。
一个 HTTP 请求发送到服务器(以及经过某些中间件),会携带很多与设备相关的信息,通过这些信息就能推断出请求是自动程序的概率。这些信息与网络环境(IP 地址)、HTTP 客户端、网络层协议等有关。
最简单直接也最容易伪装的特征是 `User-Agent`。一般带说,有道德的爬虫都会带上表明自己的身份的 UA 信息,比方说 [CommonCrawl](https://commoncrawl.org/ccbot) 爬虫的 UA 是 `CCBot`。常见 HTTP 客户端的 UA 默认固定,比方说 `curl` 的 UA 就是 `curl/版本号`,而浏览器的 UA 则复杂一些,包含操作系统、浏览器引擎版本、浏览器版本等等:
```
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/156.0.0.0 Safari/537.36
```
可以访问 [WhatMyUserAgent.com](https://whatmyuseragent.com/) 查看自己的 UA。
不少博客在评论区显示访客的操作系统和浏览器,多半就是用 UA 识别的。UA 非常容易伪装,不少编程语言的 HTTP 客户端库都可以直接设置,比如 Go 语言:
```go {hl_lines=9}
func main() {
client := &http.Client{}
req, err := http.NewRequest("GET", "http://httpbin.org/user-agent", nil)
if err != nil {
log.Fatalln(err)
}
req.Header.Set("User-Agent", "I_Am_Not_A_Bot-I_Promise")
resp, err := client.Do(req)
if err != nil {
log.Fatalln(err)
}
// ...
}
```
靠 UA 检查某个请求是不是爬虫显然不可靠,有没有别的不能改的特征呢?
有的。网络层协议 TLS 和 SSL 在建立连接时,客户端会在完成 TCP 握手后发送 Client Hello 报文,这个报文并不是加密的(因为此时加密连接还没有建立)。尽管协议规定了报文应该包含哪些字段,但并没有包含字段应该以何种**顺序**排列。每种不同的 TLS/SSL 客户端实现,都有可能在字段顺序和部分细节上有差异,而且没人会想到去改字段顺序的。底层网络库的使用者没办法像改 UA 一样改这些字段顺序,毕竟这些都是 TLS/SSL 协议的实现细节。
于是,就可以根据字段出现的顺序生成哈希字符串,判断加密请求时由什么客户端发出的。这种指纹叫作 [JA3](https://github.com/salesforce/ja3)。所有用 Python 写的爬虫,如果调用的是同一个库,JA3 指纹都是一样的,能够立马识别。
要伪装 JA3 指纹也不难,只需要**重新实现** TLS/SSL 客户端就好了。现成的库也老多了,比如 Go 语言的 [uTLS](https://github.com/refraction-networking/utls),如今的爬虫都会做 JA3 伪装。伪装的对象就是 Chrome 等真实浏览器的 TLS 特征,此外还要把操作系统、浏览器内核信息等设备信息伪装到位,比方说 TLS 层是 Firefox 的特征,但 UA 是 Chrome,甚至是 iOS 设备[^4],那必然是不可能的。
另一个改装成本比较大的特征是 IP。众所周知,如果数据中心的 IP 段信誉不好,从这个 IP 发出来的邮件就很容易被拒收,这也是为什么很多 VPS 提供商默认禁用 SMTP 端口,就是为了防止用户发垃圾邮件搞坏 IP 信誉。服务器在建立请求时也可以根据 IP 判断这个请求来自数据中心还是真人用户,用公司网络或者某些小代理提供商的代理服务上网,很有可能被反爬系统拦截,就是因为 IP 看起来很可疑。
住宅区的 IP 和数据中心的 IP 很容易区分,而大型爬虫一般都是部署在数据中心上的,所以对数据中心 IP 段的请求施加更严格的反爬措施就能够抵挡大部分爬虫…… 当然这是理论上的说法。
现实情况是,有种东西叫作住宅代理,爬虫通过这种代理发送请求就可以伪装成来自住宅区的真实用户。这些 IP 是怎么来的呢?答案是[智能家电](https://spur.us/blog/smart-tv-apps-residential-proxy-sdks)。想不到吧?你的电视盒子就可能安装了住宅代理提供商的 SDK,悄悄地用你的网络给爬虫提供服务呢。
我没了解过住宅代理的价格,但购入几十个 IP 做成旋转代理,就应该能够支撑相当高并发的爬虫,这对企业来说并不难负担。IP 一旦多起来,即便是严格的速率限制和封禁也拦不住它们了。
除了在 TLS/SSL 层伪装成浏览器,爬虫还可以用真的浏览器。预设爬虫不会运行 JavaScript 也不会存 Cookies 的想法已经过时了,爬 Linux 内核的那群人还愿意用无头浏览器硬解高难度的 PoW 算法。富翁们都愿意给 LLM 砸钱,泡沫越来越大,这点成本对他们来说不足为奇,尽管 Anthropic 和 OpenAI 都远远没有盈利,但 _“AI 实在是太好用啦!”_。
简单来说,那些爬虫完全有能力伪装成看起来完全真实的用户,并且以极大的规模和速率把你的整个网站都爬个遍。自建的 Git 服务器之所以成为重灾区,是因为人写的代码对他们来说最有价值,而且就算是小型的 Git 服务器,各种 commit 和 branch 的 URL 也非常多。
这就是在 2026 年维护网站的现状。
## 这就是偷窃
微软高管称[这种爬虫是人类历史上最大的劳动成果窃贼](https://techcrunch.com/2026/09/17/microsoft-exec-called-ai-scraping-the-largest-theft-of-labor-in-human-history-new-unredacted-filings-reveal/)。事实也确实如此,OpenAI 和 Anthropic 等模型训练公司完全不在乎训练数据的**获取**是否合乎道德(即,有多少网站为他们的爬虫支付了更高的成本,在用户体验上做了妥协),也不在乎这些训练数据的**使用**是否合法合规(即,训练数据的授权协议是否允许使用者训练模型、是否需要署名、是否需要把衍生作品用同样的协议发布、是否允许用副本及衍生作品盈利)。
我也得为他们辩解,他们的确是有*正当性*的。他们的正当性来自[美国特朗普政府的辩护](https://techcrunch.com/2026/09/02/u-s-government-sides-with-openai-on-issue-of-training-llms-on-copyrighted-material/),毕竟 _“AI 实在是太好用啦!”“国家不搞 AI 就要落后于人啦!”_
无论怎么样,他们就是在耍流氓:
1. LLM 公司贪婪地爬取整个互联网,规模之大,让许多服务器承受压力、站长承受账单;就算没有被爬,现在租赁服务器的价格也因为他们贪婪地购买硬件而变得难以支付。
2. LLM 公司既无视道德又无视法律,顶着[没打完的官司](https://en.wikipedia.org/wiki/Anthropic#Legal_issues)继续爬数据,还要[摧毁珍贵书籍](https://annas-archive.gl/blog/physical-destruction.html),滥用著佐权也践踏著作权。
最后我想提醒读者,通过任何渠道(无论是直接订阅他们的模型还是通过 OpenRouter 这样的分销商)给他们提供金钱,都是在向市场发送「我们容忍这种行为」「我们用金钱支持这种行为」的信号。如今能避免 LLM 的人可能很少了,或许只有送钱送得多还是少的区别,但这依旧是区别。
[^1]: 顺带一提,他们其中一个证书的密钥是 `4`。我十一月份的正刊一定会写这件事的。
[^2]: 如今手写的比例正在逐渐下降,你知道 Linus Torvalds [也用 Claude Code 写 Bug](https://thenewstack.io/torvalds-claude-code-kernel/) 吗?
[^3]: 要是回去发现是自家公司的爬虫干的就好玩了。
[^4]: iOS 上没有真 Chromium,全都是 AppleWebKit。
|
